Web APIからデータを取ってくる自動化スクリプト。ふだんは問題なく動くのに、たまに「503 Service Unavailable」で止まってしまう……。朝ログを見たら、たった1回のエラーでその日の処理がまるごと抜けていた、なんてこと、ありますよね。
最初は「1回失敗したらそれで終わり」という書き方になりがちです。相手のサーバーが一瞬混んでいただけでも、その日の処理が抜けてしまいます。こういう「少し待てば直るかもしれないエラー」には、時間をおいてもう一度試す(リトライ)仕組みを入れておくと、一時的なエラーで止まる場面を減らせます(どんな失敗でも防げるわけではありません)。
一時的なエラー(503や429など)のときだけ、待ち時間を1秒→2秒→4秒のように倍にしながら再挑戦する「指数バックオフ」を、Pythonで2通り書きます。
1つは自分でループを書く方法、もう1つは requests と urllib3 の Retry に任せる方法です。どちらも、パソコンの中だけで動く練習用のダミーAPIで試します。
この記事の前提
-
requestsでAPIからJSONを取ったことがある方向け。まだの方は PythonでWeb APIのJSONを取得してCSVに保存する|requests入門 から読むのがおすすめです - Pythonを動かす準備がまだの方は Python入門|環境構築と最初の1本を動かす からどうぞ
- この記事の実行例は、Debian GNU/Linux 13 の Python 3.13.5、requests 2.34.2、urllib3 2.8.0 で確認しています。外部のAPIには接続せず、ローカルのダミーAPIだけを使っています
用語メモ
| 用語 | ざっくりした意味 |
|---|---|
| リトライ | 失敗した処理を、もう一度やり直すこと |
| ステータスコード | サーバーからの返事についている3桁の番号。200は成功、404は「見つからない」、503は「今は混んでいて無理」など |
| 指数バックオフ | リトライのたびに待ち時間を2倍、4倍…と増やしていくやり方。相手が混んでいるときに追い打ちをかけないための工夫 |
| ジッター | 待ち時間にわざと少しだけ入れるランダムな「ゆらぎ」。たくさんのプログラムが同じタイミングで一斉に再挑戦するのを避ける |
| 冪等(べきとう) | 同じリクエストを何回送っても結果が変わらない性質。データを取ってくるだけのGETは、ふつう冪等です |
結論:リトライしてよいエラーだけ、間隔を広げながら再挑戦する
ポイントは3つだけです。
- 待てば直るかもしれないエラーだけリトライする(429、500、502、503、504、接続エラーなど)
- 待ち時間を倍々に増やし、回数の上限を決める(無限に続けない)
- 上限まで失敗したら、ちゃんとエラーにして止める(失敗を隠さない)
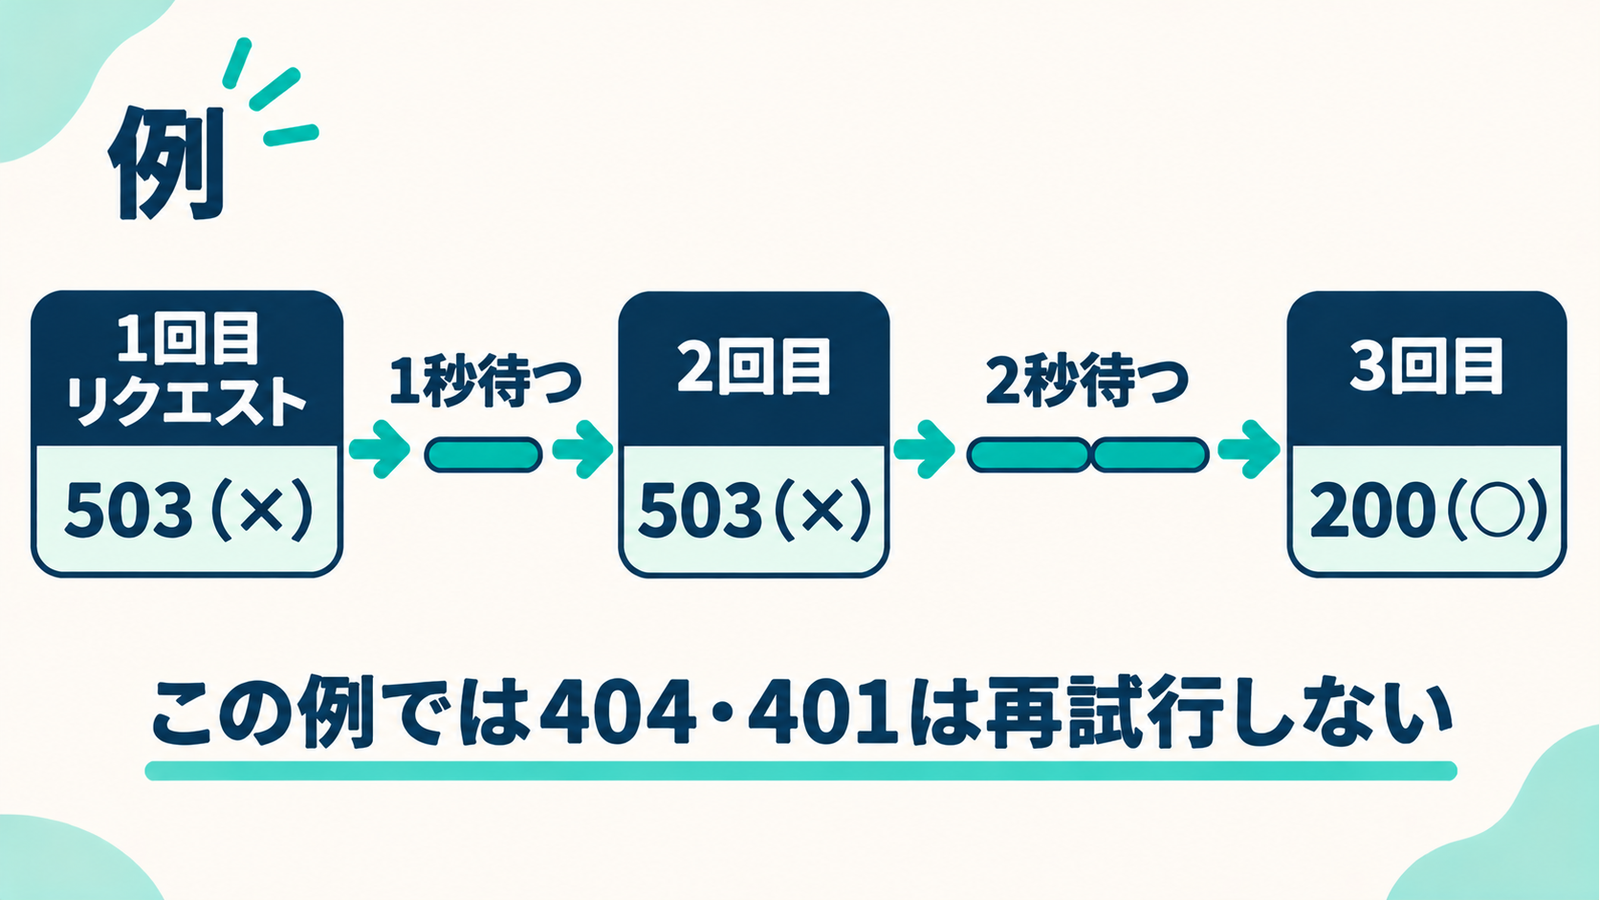
逆に、リトライしても意味がないエラーもあります。ここを分けておかないと、直らないエラーで無駄に待ち続けることになります。
| ステータス | 意味 | リトライする? |
|---|---|---|
| 429 | 送りすぎ(Too Many Requests) | する(待ってから) |
| 500 / 502 / 503 / 504 | サーバー側の一時的なトラブル | する |
| 接続エラー・タイムアウト | ネットワークが一瞬切れた、返事が遅すぎた | する |
| 400 | 送った内容がおかしい | しない(送る内容を直す) |
| 401 / 403 | 認証や権限の問題 | しない(キーや権限を確認する) |
| 404 | URLが違う、データがない | しない(URLを確認する) |
準備:わざと失敗する練習用のダミーAPIを作る
本物のAPIでリトライを試すと、相手に余計な負荷をかけたり、料金がかかるAPIなら呼び出し回数が増えたりします。そこで、パソコンの中だけで動く練習用サーバーを用意します。最初の2回は503を返し、3回目から成功する、という意地悪なサーバーです。
作業用フォルダ(例:retrydemo)を作り、次の内容を mock_server.py として保存します。
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
- 16
- 17
- 18
- 19
- 20
- 21
- 22
- 23
- 24
- 25
- 26
- 27
- 28
- 29
- 30
- 31
- 32
- 33
- 34
- 35
- 36
- 37
- 38
"""練習用のダミーAPIサーバー(ローカル専用)。
/flaky : 最初の FAIL_TIMES 回は 503、その後は 200 で JSON を返す
/notfound : いつも 404
"""
import json
import os
from http.server import BaseHTTPRequestHandler, HTTPServer

FAIL_TIMES = int(os.environ.get("FAIL_TIMES", "2"))
count = 0

class Handler(BaseHTTPRequestHandler):
    def do_GET(self):
        global count
        if self.path == "/flaky":
            count += 1
            if count <= FAIL_TIMES:
                self._send(503, {"error": "temporarily unavailable"})
            else:
                self._send(200, {"items": [{"id": 1, "name": "dummy-a"}, {"id": 2, "name": "dummy-b"}]})
        elif self.path == "/notfound":
            self._send(404, {"error": "not found"})
        else:
            self._send(404, {"error": "unknown path"})

    def _send(self, status, body):
        data = json.dumps(body).encode("utf-8")
        self.send_response(status)
        self.send_header("Content-Type", "application/json")
        self.send_header("Content-Length", str(len(data)))
        self.end_headers()
        self.wfile.write(data)

    def log_message(self, fmt, *args):
        print("[server]", self.command, self.path, "->", args[1], flush=True)

if __name__ == "__main__":
    HTTPServer(("127.0.0.1", 8000), Handler).serve_forever()
ターミナルを2つ開きます。1つ目で次を実行すると、サーバーが待ち受けを始めます(止めるときは Ctrl + C)。
- 1
python3 mock_server.pyFAIL_TIMES=10 python3 mock_server.py のように起動すると、失敗する回数を変えられます。Windows の PowerShell では $env:FAIL_TIMES = "10" を実行してから python mock_server.py で起動してください。なお、このサーバーは「何回目のアクセスか」を数えているので、試し直すときはいったん Ctrl + C で止めて起動し直します。
方法1:自分でリトライのループを書く
まずは仕組みを理解するために、自分で書いてみましょう。2つ目のターミナルで、次の retry_manual.py を同じフォルダに保存します。
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
- 16
- 17
- 18
- 19
- 20
- 21
- 22
- 23
- 24
- 25
- 26
- 27
- 28
- 29
- 30
- 31
- 32
- 33
"""自分でリトライを書く版:失敗したら 1秒→2秒→4秒 と待ち時間を倍にして再挑戦する。"""
import random
import time

import requests

API_URL = "http://127.0.0.1:8000/flaky"   # 練習用のダミーAPI
RETRY_STATUS = {429, 500, 502, 503, 504}  # 「待てば直るかもしれない」ステータス
MAX_TRIES = 4                             # 最初の1回+リトライ3回


def fetch_with_retry(url: str) -> dict:
    for attempt in range(1, MAX_TRIES + 1):
        try:
            res = requests.get(url, timeout=10)
        except (requests.ConnectionError, requests.Timeout) as e:
            reason = type(e).__name__
        else:
            if res.status_code not in RETRY_STATUS:
                res.raise_for_status()      # 404 などはリトライせず、すぐエラーにする
                return res.json()
            reason = f"HTTP {res.status_code}"

        if attempt == MAX_TRIES:
            raise RuntimeError(f"{MAX_TRIES}回試しても失敗しました(最後の理由: {reason})")
        wait = 2 ** (attempt - 1) + random.uniform(0, 0.5)   # 1, 2, 4秒 + ゆらぎ
        print(f"{attempt}回目失敗({reason})。{wait:.1f}秒待って再挑戦します")
        time.sleep(wait)


if __name__ == "__main__":
    data = fetch_with_retry(API_URL)
    print("取得できた件数:", len(data["items"]))
python3 retry_manual.py を実行すると、次のように表示されました。待ち時間はゆらぎ(ジッター)が入るので、実行するたびに少し変わります。
- 1
- 2
- 3
1回目失敗(HTTP 503)。1.3秒待って再挑戦します
2回目失敗(HTTP 503)。2.4秒待って再挑戦します
取得できた件数: 2
サーバー側のターミナルには、503が2回、そのあと200が1回、記録されていました。
- 1
- 2
- 3
[server] GET /flaky -> 503
[server] GET /flaky -> 503
[server] GET /flaky -> 200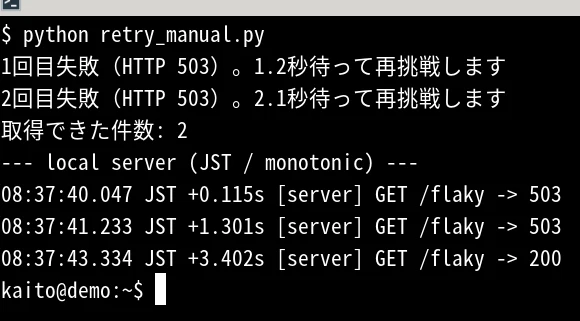
サーバーを FAIL_TIMES=10 で起動し直して同じスクリプトを動かすと、4回試したところであきらめて、次のエラーで終了しました。上限を決めているので、いつまでも待ち続けることはありません。
- 1
RuntimeError: 4回試しても失敗しました(最後の理由: HTTP 503)コードのポイントです。
-
RETRY_STATUSに入っているステータスのときだけ待って再挑戦し、それ以外(404など)はraise_for_status()ですぐにエラーにします -
2 ** (attempt - 1)が「1, 2, 4秒…」と倍になる部分です。random.uniform(0, 0.5)でゆらぎを足しています -
timeout=10を必ず付けます。付けないと、相手が返事をしないときに、いつまでも待ち続けることがあります
方法2:requests と urllib3 の Retry に任せる
毎回ループを書くのは大変なので、実務ではライブラリに任せるのがラクです。requests は内部で urllib3 というライブラリを使っていて、その Retry という設定を渡すと、リトライを自動でやってくれます。urllib3 は requests と一緒にインストールされるので、追加のインストールは不要です。
retry_session.py として保存します。
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
- 16
- 17
- 18
- 19
- 20
- 21
- 22
- 23
- 24
- 25
- 26
- 27
"""requests + urllib3 の Retry にリトライを任せる版。"""
import requests
from requests.adapters import HTTPAdapter
from urllib3.util import Retry

API_URL = "http://127.0.0.1:8000/flaky"   # 練習用のダミーAPI


def make_session() -> requests.Session:
    retry = Retry(
        total=3,                                  # リトライは最大3回(最初の1回は含まない)
        backoff_factor=1,                         # 待ち時間の基準(秒)
        status_forcelist=[429, 500, 502, 503, 504],
        allowed_methods=["GET"],                  # 何度送っても結果が変わらない GET だけ
    )
    session = requests.Session()
    adapter = HTTPAdapter(max_retries=retry)
    session.mount("http://", adapter)
    session.mount("https://", adapter)
    return session


if __name__ == "__main__":
    session = make_session()
    res = session.get(API_URL, timeout=10)
    res.raise_for_status()
    print("ステータス:", res.status_code, "件数:", len(res.json()["items"]))
サーバーを FAIL_TIMES=2(何も付けずに起動した場合と同じ)で起動し直して実行すると、次のように成功しました。
- 1
ステータス: 200 件数: 2Retry の主な設定はこちらです。
| 設定 | 意味 |
|---|---|
total | リトライの合計回数の上限。最初の1回は含まないので、3 なら最大4回アクセスします |
backoff_factor | 待ち時間の基準(秒)。リトライのたびに倍になります |
status_forcelist | このステータスが返ってきたらリトライする、というリスト |
allowed_methods | リトライしてよいHTTPメソッド。初期値はGETやPUTなど冪等なものだけで、POSTは含まれません |
待ち時間がどうなるか、失敗し続けるサーバー(FAIL_TIMES=10)で確かめました。サーバー側の時刻を見ると、アクセスの間隔は約0秒→2秒→4秒でした(通信にかかる時間の分だけ、ほんの少し長くなります)。urllib3 の公式ドキュメントにも「2回目の試行(最初のリトライ)は待たずに行い、その後は倍々に伸びる」という説明があり、そのとおりの動きです。合計4回アクセスしたあと、次のエラーで止まりました。
- 1
requests.exceptions.RetryError: HTTPConnectionPool(host='127.0.0.1', port=8000): Max retries exceeded with url: /flaky (Caused by ResponseError('too many 503 error responses'))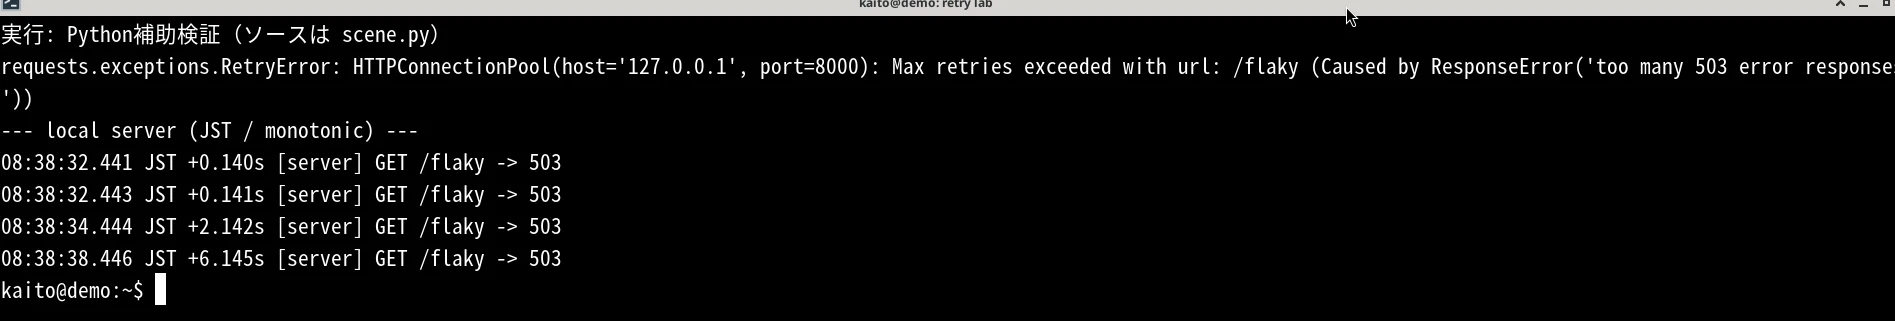
もうひとつ大事な確認です。status_forcelist に入っていない404のURL(ダミーAPIの /notfound)にアクセスすると、リトライはされず、1回だけで404がそのまま返ってきました。つまり、404は例外にならず普通に返ってくるので、方法2でも res.raise_for_status() を忘れずに書いておきましょう。ここは見落としやすいところです。
自分のスクリプトに組み込むときは、AIにこう頼むとスムーズです。
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
次のPythonスクリプトの requests.get の部分に、リトライを入れたいです。

【条件】
- requests.Session に HTTPAdapter と urllib3 の Retry を設定する
- リトライするのは 429, 500, 502, 503, 504 のときだけ。total=3, backoff_factor=1
- リトライするメソッドは GET だけ(POST は入れない)
- timeout=10 を必ず付ける
- 最後に raise_for_status() で失敗を検知する
- APIキーはコードに書かず、環境変数から読む形のままにする

【今のコード】
(ここに貼る。APIキーやURLのトークン部分は伏せる)
429(送りすぎ)と Retry-After ヘッダー
APIによっては、429や503の返事に Retry-After というヘッダー(「何秒後に来てね」という指示)を付けてくれることがあります。urllib3 の Retry は、初期設定(respect_retry_after_header=True)で、413・429・503 のときにこのヘッダーがあれば、その秒数だけ待ってからリトライします。
一方、方法1の手書き版(retry_manual.py)は、Retry-After を読みません。仕組みを理解するための学習用なので、相手が「2秒待って」と指示していても、自分で計算した待ち時間で再挑戦してしまいます。実際に使うときは、方法2の Retry に任せるか、Retry-After を読んで待つ処理を足してください。
自分でループを書く場合も、相手の指示があるならそれに従うのがマナーです。APIの公式ドキュメントに「何秒あけてね」「1分に何回まで」といったルールが書かれていることが多いので、先に確認しておきましょう。
POST を気軽にリトライしない
ここは本当に大事なところです。データを取ってくるだけのGETと違って、POST(データを送る・登録する)は、リトライすると二重登録になることがあります。たとえば「送信はサーバーに届いて登録されたのに、返事だけがタイムアウトした」場合、もう一度送ると同じデータが2件できてしまいます。
Retry の初期設定でPOSTがリトライ対象に入っていないのは、このためです。POSTでリトライしたいときは、
- 相手のAPIが「同じリクエストを何度送っても1回分として扱う」仕組みを用意しているか、公式ドキュメントで確認する
- 送る側で「送ったかどうか」を記録し、重複しても困らない設計にする
といった工夫が必要です。通知の送信(POST)でのリトライの考え方は Pythonの自動化結果をDiscordに通知する|Webhook URLの作り方と送信コード で、データ登録のPOSTは PythonからGASのWebアプリにデータを送ってスプレッドシートに追記する|doPostの作り方 で扱っています。
セキュリティの注意
- リトライには、回数と処理全体の時間の上限を決めておきましょう。
timeoutは1回のアクセスの待ち時間で、処理全体の締め切りではありません - 方法1の手書き版は、
Retry-Afterに対応していない学習用です。実際に使うときは、相手が指定した待ち時間を守る形(方法2など)にしてください - 自動でリトライするのは、GETのように何度実行しても結果が変わらない操作だけにします。POSTを送り直すなら、重複を防ぐ仕組みが必要です
-
requestsとurllib3は、セキュリティ修正の入った新しい版を使いましょう。証明書の確認を切るverify=Falseは使わないでください - エラーやログに出るURLに、APIキーなどが含まれていないかも確認しておきましょう
参考:urllib3 の Retry(公式ドキュメント)、urllib3 のセキュリティ告知(GitHub)
つまずきやすい点
| 症状 | 原因 | 対処 |
|---|---|---|
| リトライしているはずなのに1回で止まる | status_forcelist にそのステータスが入っていない、またはメソッドが allowed_methods に入っていない | ステータスとメソッドの設定を見直す |
| 404でもエラーにならず先に進んでしまう | 404はリトライ対象外で、例外ではなく普通の返事として返る | raise_for_status() を書く |
| スクリプトがいつまでも終わらない | timeout を付けていない | timeout=10 などを必ず付ける |
| 同じデータが2件登録された | POSTをリトライした | POSTはリトライしない、または重複に強い設計にする |
| リトライで余計にAPIの利用回数が増えた | 回数の上限が多すぎる、間隔が短すぎる | total を小さめにし、backoff_factor で間隔をあける |
料金がかかるAPIでは、リトライの回数もそのまま利用回数に数えられることがあります。上限は小さめから始めるのが安心です。
エラーが出て原因がわからないときは、こんなふうにAIに相談してみてください。
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
Pythonの requests と urllib3 の Retry でAPIを呼んでいます。
次のエラーで止まりました。リトライの設定が正しいか、原因の候補と確認する順番を教えてください。

【エラーメッセージ】
(ここに貼る。URLに含まれるキーやトークン、個人の情報は伏せる)

【Retry の設定】
total=3, backoff_factor=1, status_forcelist=[429, 500, 502, 503, 504], allowed_methods=["GET"]
まとめ
- 一時的なエラー(429・5xx・接続エラー)だけを、回数の上限つきでリトライする
- 待ち時間は倍々に伸ばす(指数バックオフ)。ゆらぎ(ジッター)を足すとさらに安全
- 実務では
requests.Session+HTTPAdapter+Retryに任せるとラク - 404などはリトライされないので、
raise_for_status()で失敗を検知する - POSTは二重登録の危険があるので、気軽にリトライしない
次の一歩は、今動かしているスクリプトの requests.get を1か所だけ、Retry つきのセッションに置き換えてみることです。そのうえで、最後まで失敗したときに気づけるように、Pythonの自動化結果をDiscordに通知する|Webhook URLの作り方と送信コード で通知を足していきましょう。
関連する本・記事
- この記事のシリーズ(次の記事):Pythonの自動化結果をDiscordに通知する|Webhook URLの作り方と送信コード
- GAS側から通知したいなら:GASからSlackに通知する|Incoming WebhookのURLをスクリプトプロパティで安全に使う
- PythonからスプレッドシートへPOSTしたいなら:PythonからGASのWebアプリにデータを送ってスプレッドシートに追記する|doPostの作り方
- n8nで失敗に気づきたいなら:n8nのワークフローが失敗したらDiscordに通知する|Error Triggerでエラー用ワークフローを作る
- APIからJSONを取る基本:PythonでWeb APIのJSONを取得してCSVに保存する|requests入門
- リトライした記録を残すなら:Pythonの自動化スクリプトにログを残す|loggingで実行時刻・処理件数・エラーを記録する
- APIキーを安全に扱うには:APIキーをコードに直書きしない|.envと環境変数で安全に管理する(Python・GAS)
- 毎朝決まった時刻に動かすなら:毎朝の作業をPCを触らず動かしたい|cron入門(Pythonを定時実行)
- メンバーのKindle本の一覧:biliotechまわりのKindle著書リスト
より詳しく知りたいときは、公式ドキュメントの urllib3 Utilities(Retry) と Requests: Advanced Usage も参考になります。